运动控制算法全景:从梯形 / S 形曲线、电子凸轮飞剪,到强化学习与”大脑-小脑”分层架构
前面两篇,一篇讲运动控制器是什么、五种连 PC 方式怎么选(硬件与接口),一篇讲EtherCAT 的标准体系谁管谁(协议与行规)。但中间还留着最要紧的一层没说:控制器拿到一条”走过去”的指令之后,里面到底在算什么?
同样是”从 A 点走到 B 点”,有的设备走起来稳、停得准、没有异响,有的一启停就”哐”一声、高速拐角还过切。差别不在电机,也不在驱动器,而在轨迹是怎么生成的、多轴之间是怎么对时的。这篇把这一层拆开:从最基础的梯形与 S 形加减速,一路讲到飞剪追剪、龙门同步,最后落到当下最热的强化学习与”大脑-小脑-脊髓”分层架构。
全篇一句话:运动控制的本质,是把几何变成带时间戳的设定值,再让所有轴在同一个时刻生效。所有算法——加减速、插补、电子齿轮、凸轮、交叉耦合——都是在解决这件事的某个侧面;而所谓 AI 时代的分层架构,并不是新发明,只是给这套早就存在的分层换了个最上层。
本文路线(从底层数学到前沿架构,共八节)
① 分层与频率
② 梯形 / 7 段 S 曲线
③ 插补与速度前瞻
④ 电子齿轮 / 凸轮
⑤ 飞剪追剪同步
⑥ 龙门交叉耦合
⑦ 强化学习
⑧ 大脑-小脑-脊髓
一、先分层:路径、轨迹、设定值、电流
最容易混淆的一组概念是 Path(路径) 与 Trajectory(轨迹):
- 路径只有几何:一条直线、一段圆弧、一串样条控制点。它回答”经过哪里”,不包含时间。
- 轨迹是路径 + 时间律:在每个时刻该在什么位置、有多大速度、多大加速度。它回答”何时到达何处”。
把路径变成轨迹叫时间参数化(time parameterization),这是轨迹规划的核心。MoveIt、OMPL 这类规划器输出的通常是路径,后面必须再接一层时间参数化,才能变成驱动器能执行的设定值。
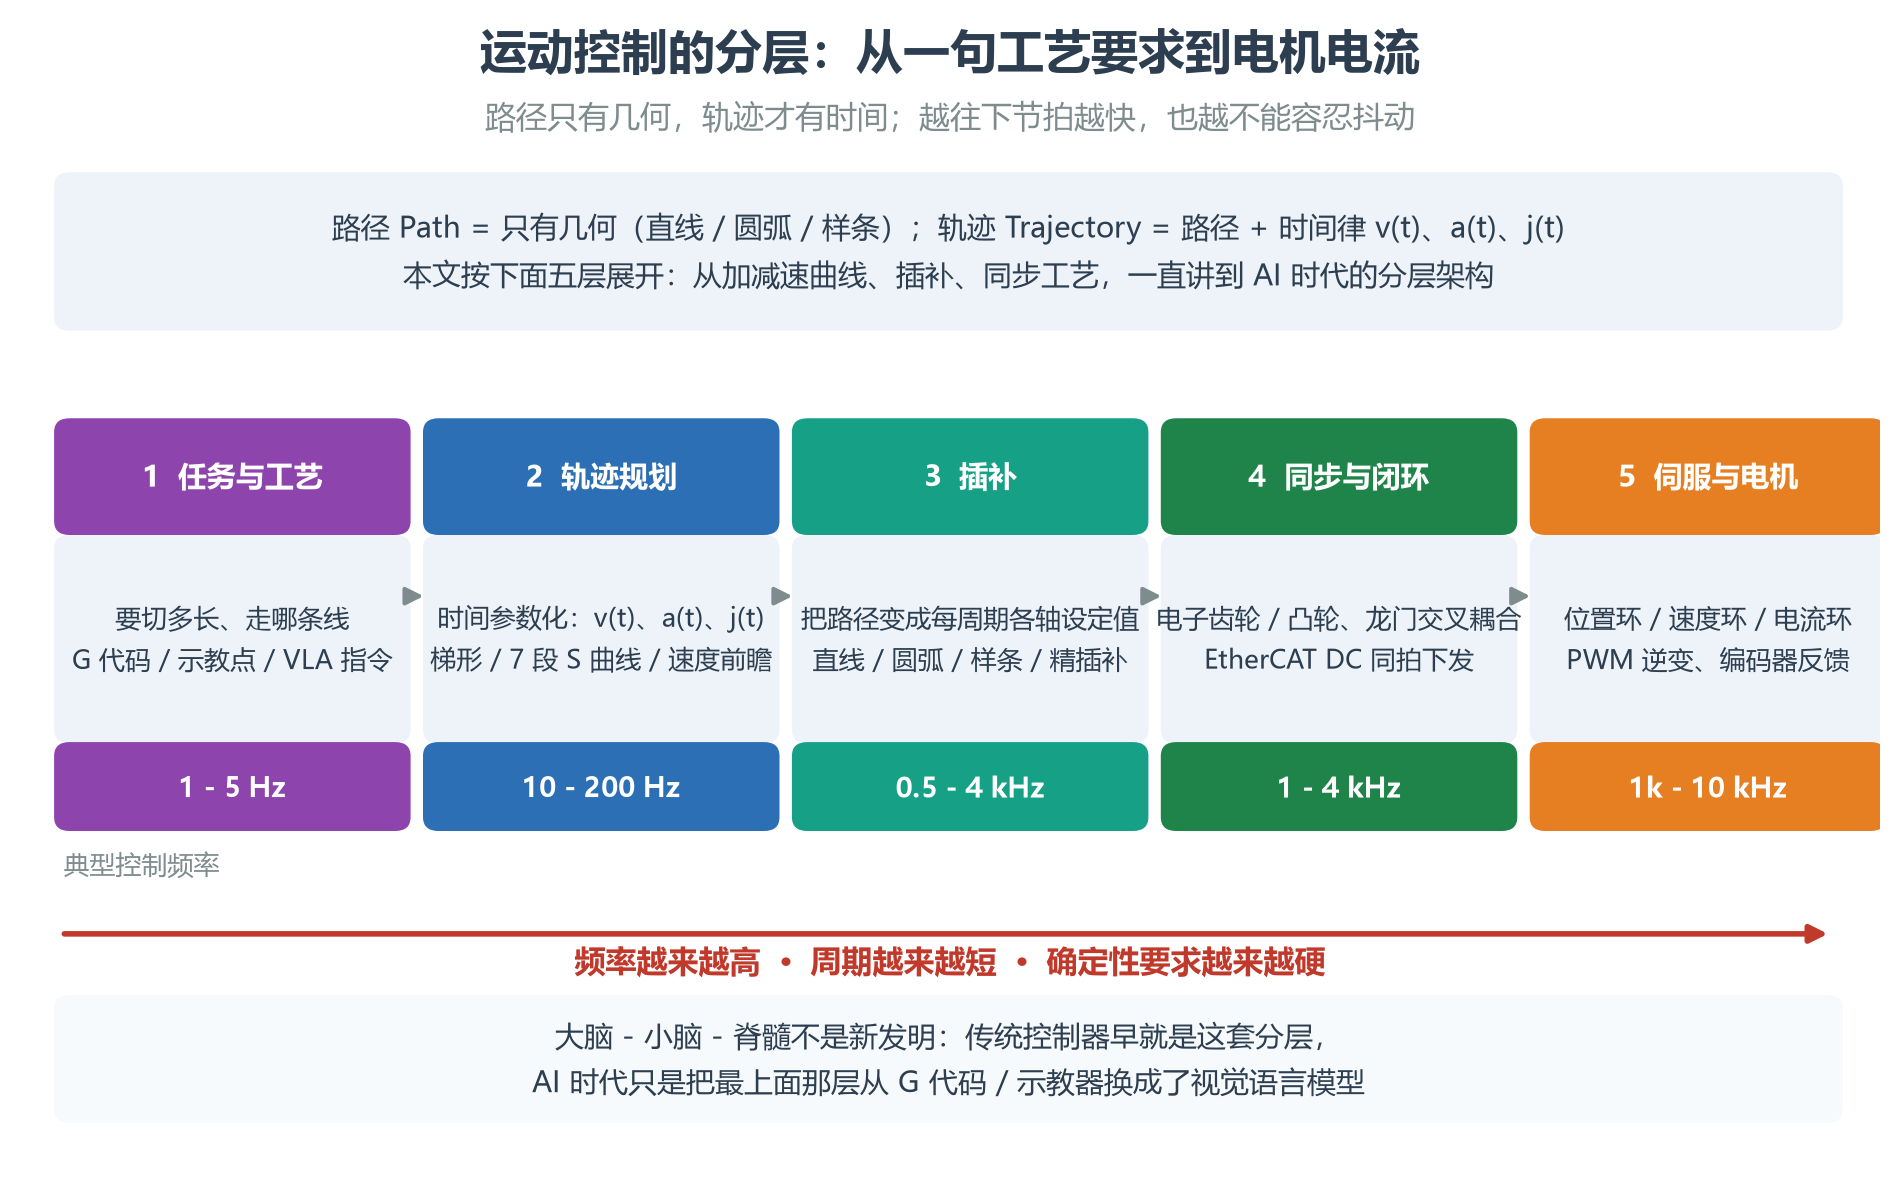
这张图里最值得记住的不是五个框,而是下面那行频率:
| 层 | 典型频率 | 算什么 | 典型周期 |
|---|---|---|---|
| 任务与工艺 | 1 – 5 Hz | 切多长、走哪条线、G 代码 / 示教点 / 指令 | 200 ms – 1 s |
| 轨迹规划 | 10 – 200 Hz | v(t)、a(t)、j(t)、速度前瞻、时间参数化 | 5 – 100 ms |
| 插补 | 0.5 – 4 kHz | 把路径变成每周期各轴的设定位置 | 0.25 – 2 ms |
| 同步与闭环 | 1 – 4 kHz | 电子齿轮 / 凸轮、龙门交叉耦合、总线同拍下发 | 0.25 – 1 ms |
| 伺服与电机 | 1k – 10 kHz | 位置环 / 速度环 / 电流环、PWM、编码器反馈 | 0.1 – 1 ms |
越往下,节拍越快,也越不能容忍抖动。这也是为什么上一篇讲接口时反复强调”最坏情况”而不是平均延迟——普通以太网平均延迟可能更低,但只要偶发一次抖动,1 ms 的插补周期就漏了一个设定值,表面质量立刻看得出来。
埋个伏笔:本文最后一节会讲”大脑-小脑-脊髓”三层架构。你回头对照这张表会发现,它和传统运动控制器的”任务 / 轨迹规划 → 精插补 → 伺服环”几乎是同一套切法。分层不是 AI 带来的,是毫秒预算逼出来的。
二、轨迹规划:梯形与 7 段 S 形,差别全在第三阶导数
先写清三个量:
v = dx/dt(速度) a = dv/dt(加速度) j = da/dt(加加速度,jerk)
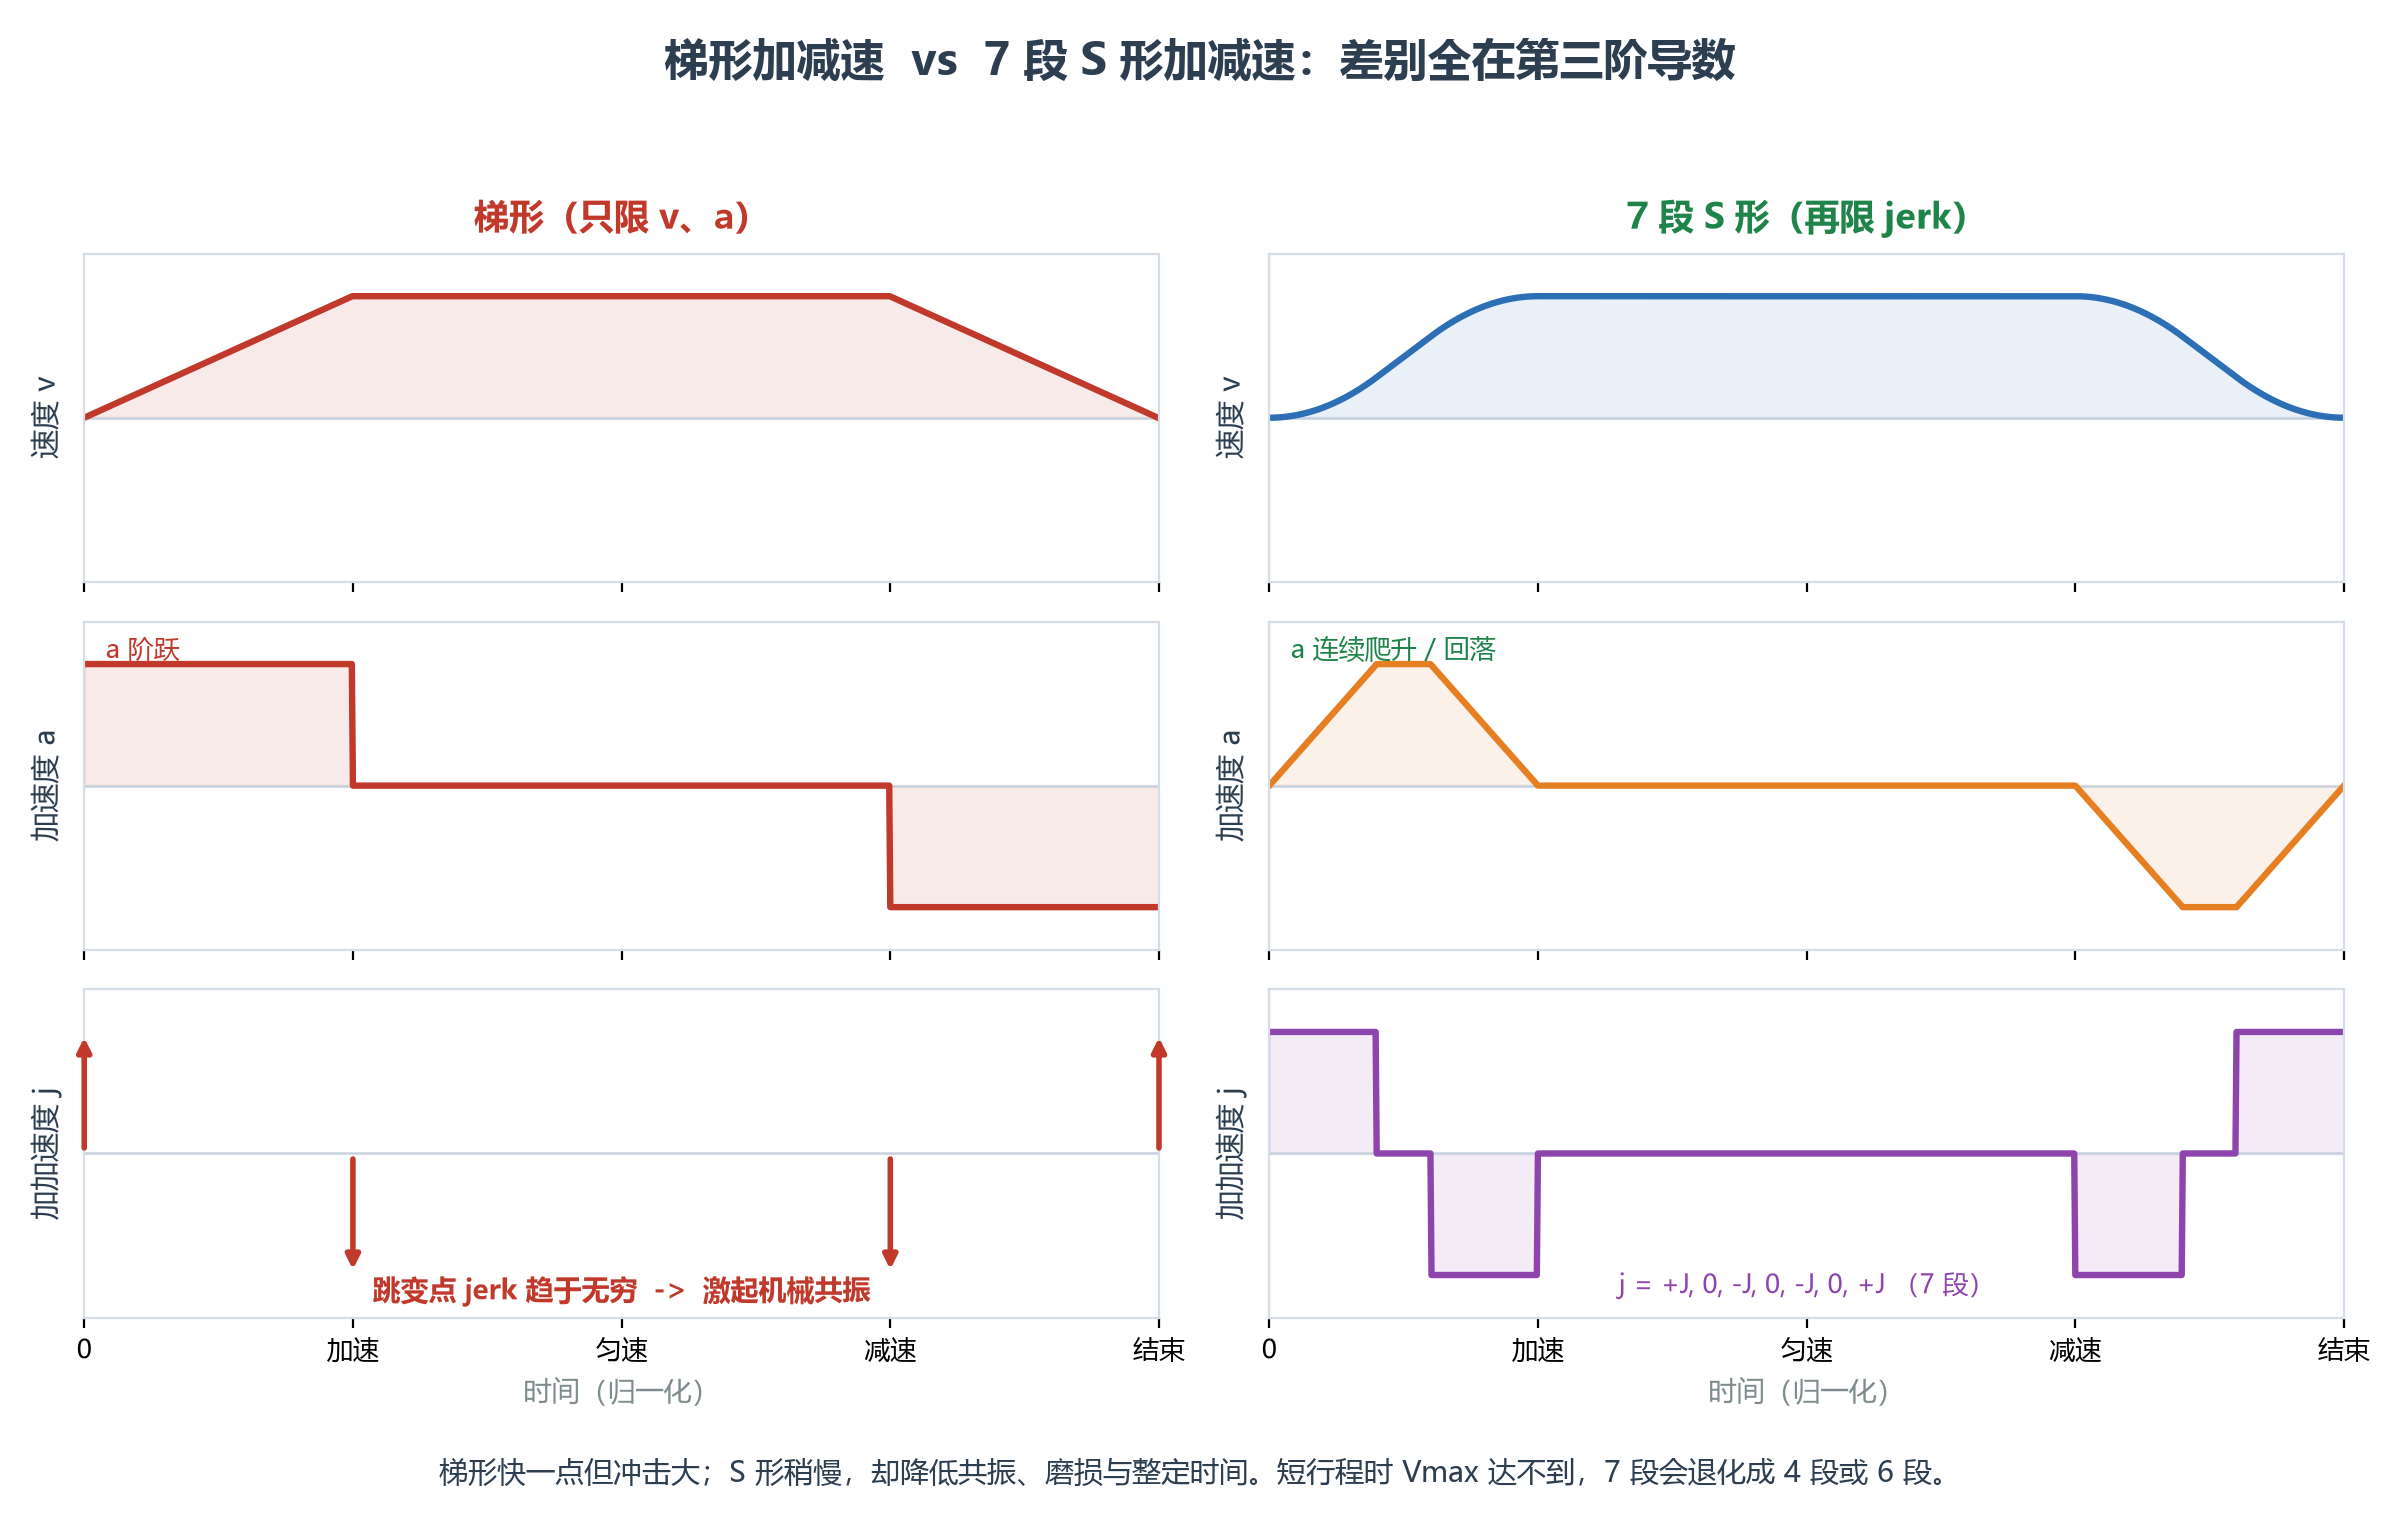
梯形:只约束 v 和 a
梯形速度曲线是最经典的做法:以恒定 amax 加速到 vmax,匀速一段,再以 -amax 减速到零。速度图形是个梯形(行程短、达不到 vmax 时退化成三角形)。
问题是加速度在三个拐点上是阶跃的:从 0 直接跳到 amax。这意味着 jerk 在这些点趋于无穷。工程后果非常具体:
- 激起机械共振,尤其龙门、长横梁、皮带这类柔性传动;
- 转矩需求突变,电流尖峰;
- 导轨、丝杠、联轴器冲击磨损,加工表面出现振纹;
- 停稳后要等振动衰减才能开始下一步,整定时间反而变长——所以”梯形更快”经常是个错觉。
7 段 S 形:把 jerk 也管起来
S 形曲线的做法是给 jerk 设上限 jmax,让加速度连续地爬升、保持、回落。标准 rest-to-rest 运动被切成 7 段:
| 段 | jerk | 加速度 a | 阶段名 |
|---|---|---|---|
| 1 | +J | 0 → +A | 加加速 |
| 2 | 0 | 保持 +A | 匀加速 |
| 3 | -J | +A → 0 | 减加速(达到 vmax) |
| 4 | 0 | 0 | 匀速 |
| 5 | -J | 0 → -A | 加减速 |
| 6 | 0 | 保持 -A | 匀减速 |
| 7 | +J | -A → 0 | 减减速(速度归零) |
七个段长度分别记作 Tj, Ta, Tj, Tv, Tj, Ta, Tj,只要行程够长就能凑齐;行程短、达不到 vmax 或 amax 时,第 2、4、6 段会塌掉,7 段退化成 6 段、4 段甚至更少——这是实际调机时最容易困惑的地方:同一套参数,长行程漂亮,短行程却”发软”,因为曲线形态根本变了。
// 7 段 S 曲线骨架(示意:每段给定 jerk 符号与时长)
typedef struct { double T; int sign; } Seg;
Seg prof[7] = {
    { Tj, +1 }, { Ta, 0 }, { Tj, -1 }, { Tv, 0 },
    { Tj, -1 }, { Ta, 0 }, { Tj, +1 }
};
// 每个控制周期 Ts 积分一次,下发设定值
for (int i = 0; i != 7; i++) {
    a += prof[i].sign * Jmax * Ts;
    v += a * Ts;
    s += v * Ts;
    setpoint = s;                 // 送到位置环 / 总线
    if (s >= S_target) break;    // 短行程时提前结束,7 段自然退化
}
真实实现要处理的远不止这些:整数采样周期对齐、端点舍入误差(通常微调 vstart 或 vend 吸收)、以及各段时长随行程动态求解。但骨架就是这个。
参数怎么定:不是拍脑袋,是被物理约束住的
- amax 由转矩 / 力决定:旋转轴 Treq = Jeq·α + Tload + Tfric,直线轴 Freq = meq·a + Fload + Ffric。别超过驱动器电流上限。
- jmax 由结构刚性决定,工程经验常取最大加速度的 10 ~ 20 倍/秒量级。柔性系统(龙门、长梁)对 jerk 比对加速度更敏感:出现纹波、余振,先减 jmax 往往比减 amax 更有效。
- 拐角还要另限速:曲线上 an = v²/R,所以拐角速度必须满足
v ≤ sqrt(a_max · R)。哪怕直线段允许很高速度,曲率也会把速度压下来。
再往上还有三次样条(C¹ 连续,加速度可能跳变)、五次多项式(约束起止位置/速度/加速度共 6 个边界条件,C² 连续,从根上消掉 jerk 尖峰,晶圆搬运、光学检测常用)以及 B 样条 / NURBS(高阶连续,CNC 五轴加工)。还有 TOPP / TOPP-RA 这类时间最优路径参数化:给定路径几何与各轴限制,反解出最快的时间律。它们的共同目标都是一件事——在不激起机械共振的前提下,把节拍压到极限。
三、插补与速度前瞻:小线段加工为什么必须”往前看”
轨迹规划给出时间律,插补负责把它变成每个控制周期、每个轴的具体设定位置。工程上通常分两级:
- 粗插补:在任务空间(笛卡尔空间)生成路径点、waypoint,处理直线 / 圆弧 / 样条;
- 精插补:在关节空间或轴空间,按控制周期(典型 1 ms)算出各轴设定值,交给位置环。
单段轨迹好办,麻烦在连续小线段。模具雕刻、激光切割、异形轮廓里有成千上万条几毫米长的线段,如果每段都规规矩矩加速到 v、再减速到 0,节拍会被吃光,机床还会一路”点头”。
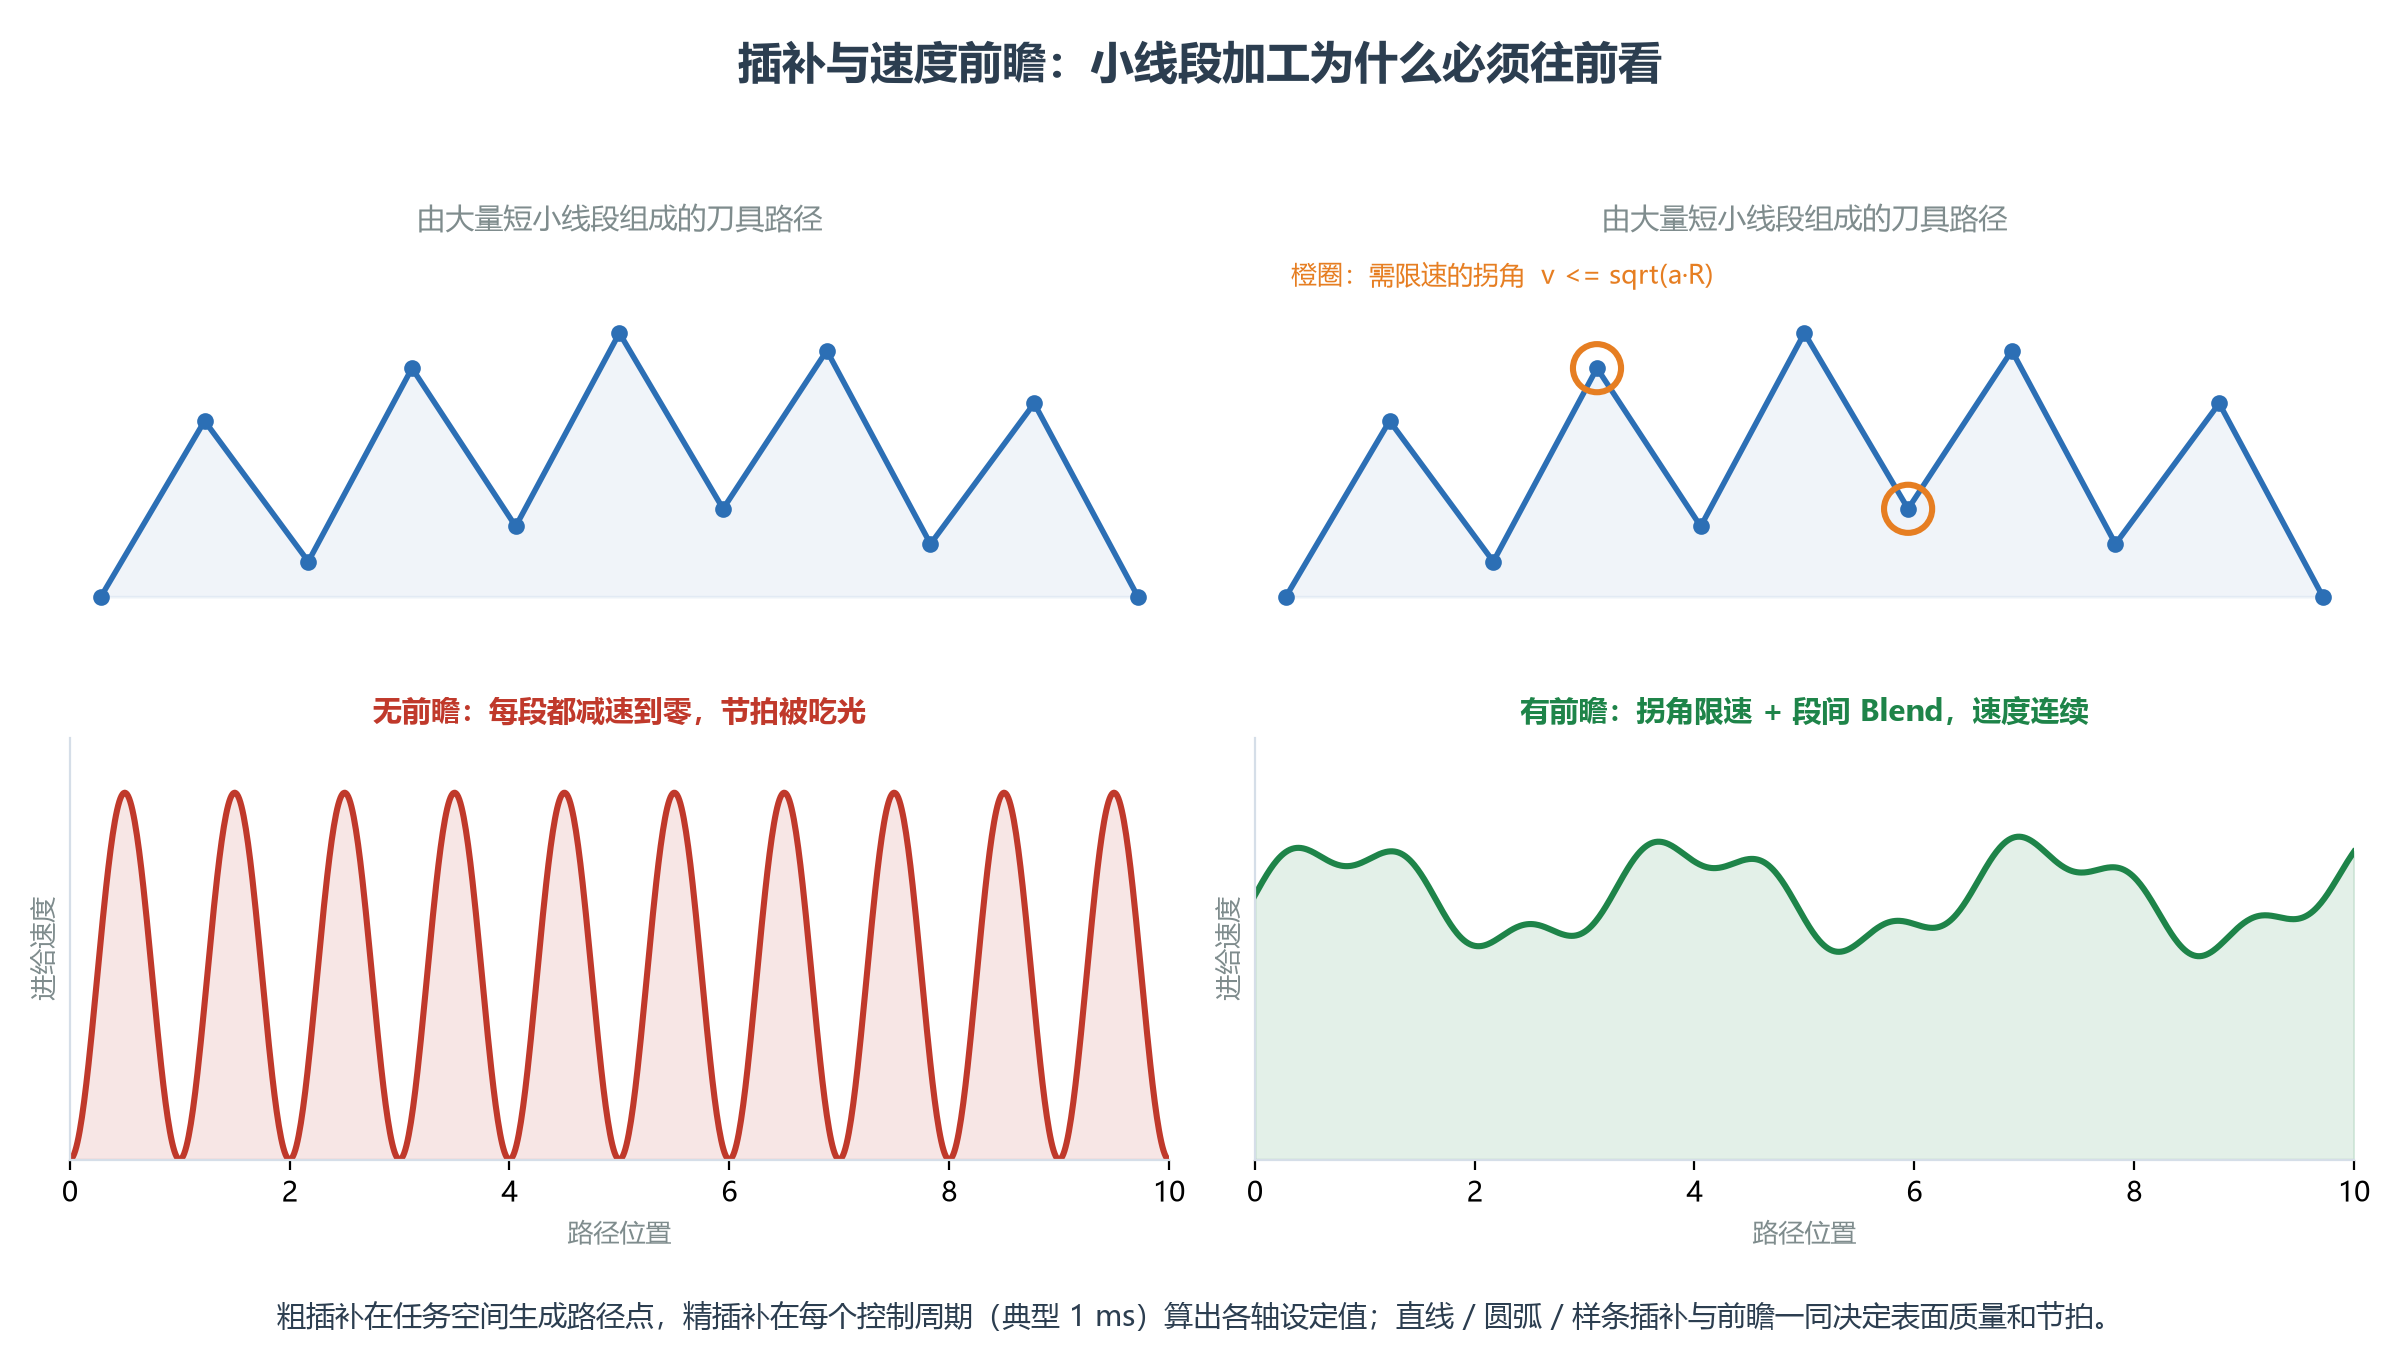
速度前瞻(look-ahead)就是提前读入后面 N 段,预判拐角、预先限速、让段间平滑过渡:
- 按拐角曲率或夹角算出该点允许通过速度
v ≤ sqrt(a_max · R); - 从后往前反推,保证每个拐角都来得及减速;
- 段间用 Blend / 多项式过渡,不停车直接换向;
- 再叠加整段 S 曲线加减速,保证 a、j 连续。
前瞻段数不是越多越好:要平衡缓冲区内存、计算量和工艺需求。但有一点很确定——没有前瞻,再好的加减速曲线也救不了小线段加工。这也正是开源 CNC 那篇里反复出现的”连续插补型控制器”值钱的地方。
四、从”单轴怎么动”到”轴与轴怎么配合”:电子齿轮与电子凸轮
前面讲的都是一根轴。真实设备里,难点几乎总在多轴之间的时间关系:传送带在走,切刀要跟上;印刷套色要对齐;龙门两端要同步。
机械时代靠齿轮箱、凸轮箱、传动轴硬连;电气时代把这些关系写成软件函数,于是有了电子齿轮与电子凸轮。这里有个关键抽象:主轴(Master)不一定是真实电机,它可以是实轴编码器反馈、外部测速轮,也可以是控制器内部生成的虚轴。虚轴让整条产线有了一个统一的”时间基准”,所有从轴都跟着它的相位走。
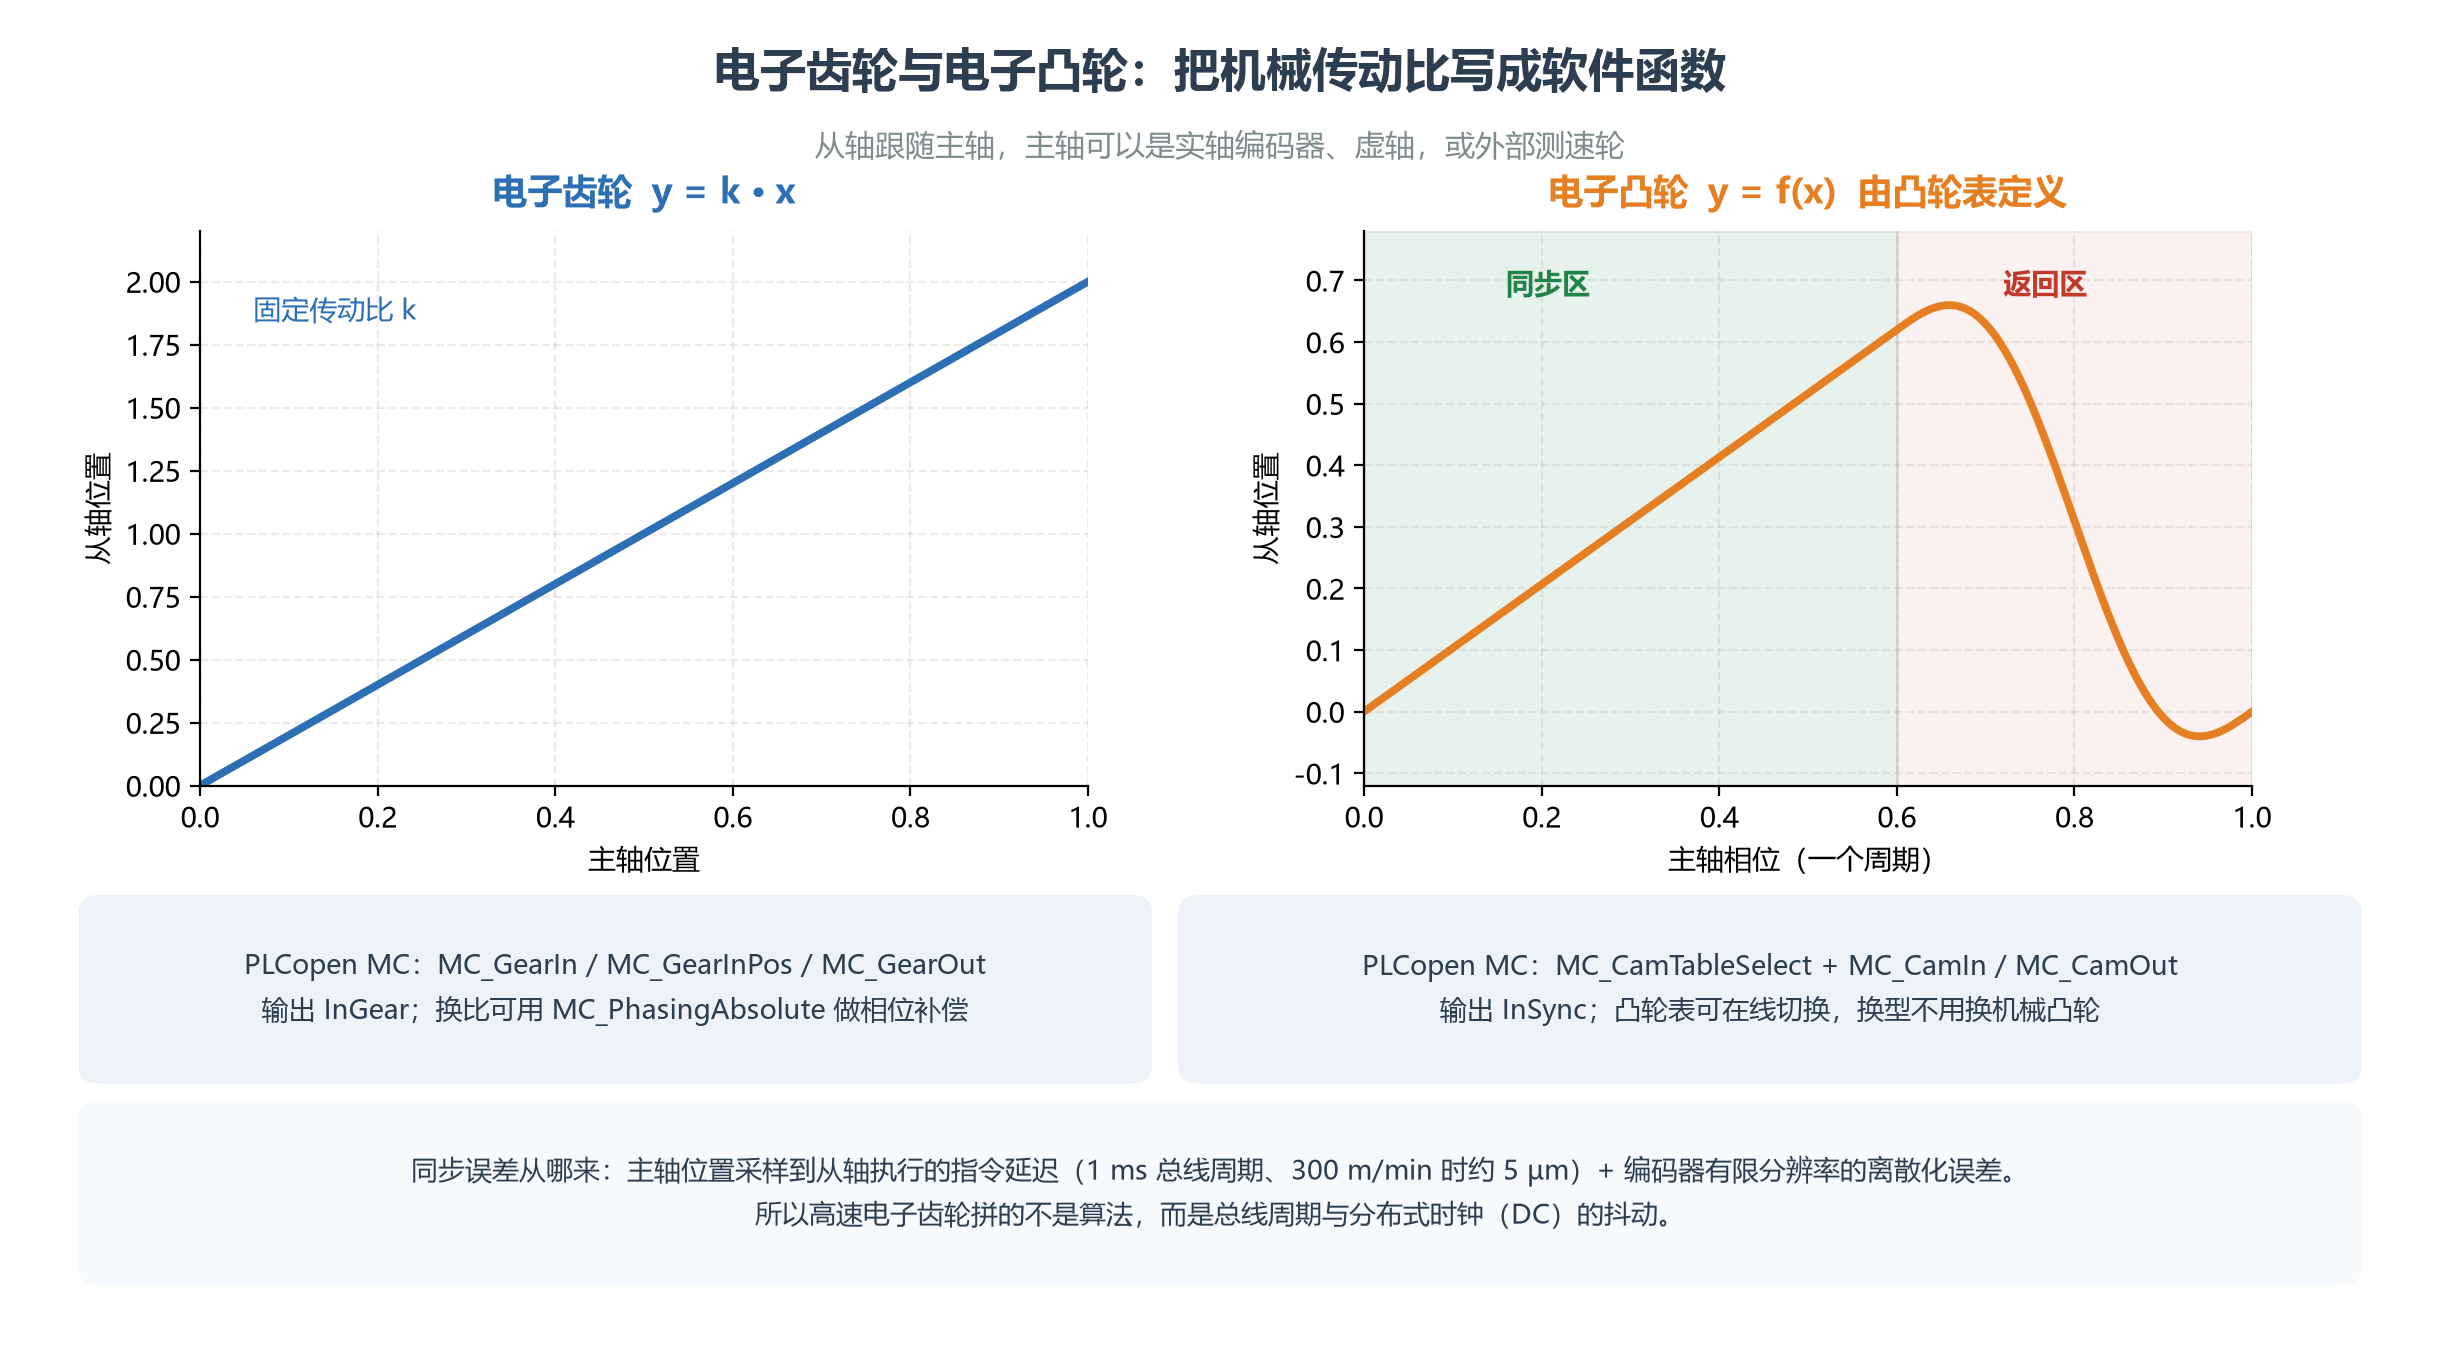
电子齿轮:固定传动比
从轴位置严格等于主轴位置乘一个有理数比 k(分子/分母表示,避免浮点误差),用于定长送料、无轴传动套色印刷等。PLCopen 把它标准化成 MC_GearIn / MC_GearInPos / MC_GearOut,输出 InGear 表示已进入同步;相位微调用 MC_PhasingAbsolute / MC_PhasingRelative;甚至有 CombineAxes 让一个从轴跟随两个主轴的合成。
高速电子齿轮拼的不是算法,是延迟。同步误差主要来自两处:一是主轴位置采样到从轴执行之间的指令延迟——1 ms 总线周期、300 m/min 线速度下,1 ms 就对应约 5 µm 的位置偏差;二是编码器有限分辨率带来的离散化误差。所以这里的瓶颈落在总线周期与分布式时钟(DC)的抖动上,而不是你的齿轮比算得多精。这也解释了为什么 CSP 模式必须用 DC 同步。
电子凸轮:任意位置函数
凸轮把”主轴相位 → 从轴位置”定义成一张表(常见 256 ~ 1024 点),控制器按表插值。换产品只需换一张表,不用停机修磨机械凸轮,这是包装、印刷设备换型效率的分水岭。PLCopen 对应 MC_CamTableSelect + MC_CamIn / MC_CamOut,输出 InSync。
凸轮曲线设计是真正见功力的地方,要同时满足三类约束:
- 运动学:速度、加速度、跃度连续,不能有尖峰;
- 动力学:惯性力与力矩平滑,别把电机和减速机冲击坏(选型参见电机与减速机那篇);
- 工艺:同步区速度必须精确匹配、返回区时间必须够短,赶得上下一个周期。
顺带说一句标准化:这些功能块属于 PLCopen MC Part 1/2(v2.0,建立在 IEC 61131-3 之上),还定义了每根轴固定的状态机;而驱动层由 IEC 61800-7 与 CiA 402 等行规约束。上下两层标准一叠,才使得”换个品牌的控制器/驱动器,程序还能跑”成为可能。
五、飞剪 / 追剪:电子凸轮的期末考
如果说电子齿轮是课后习题,飞剪(flying shear)就是期末考:材料连续高速前进,绝不能停,切刀必须在运动过程中完成定长切断。
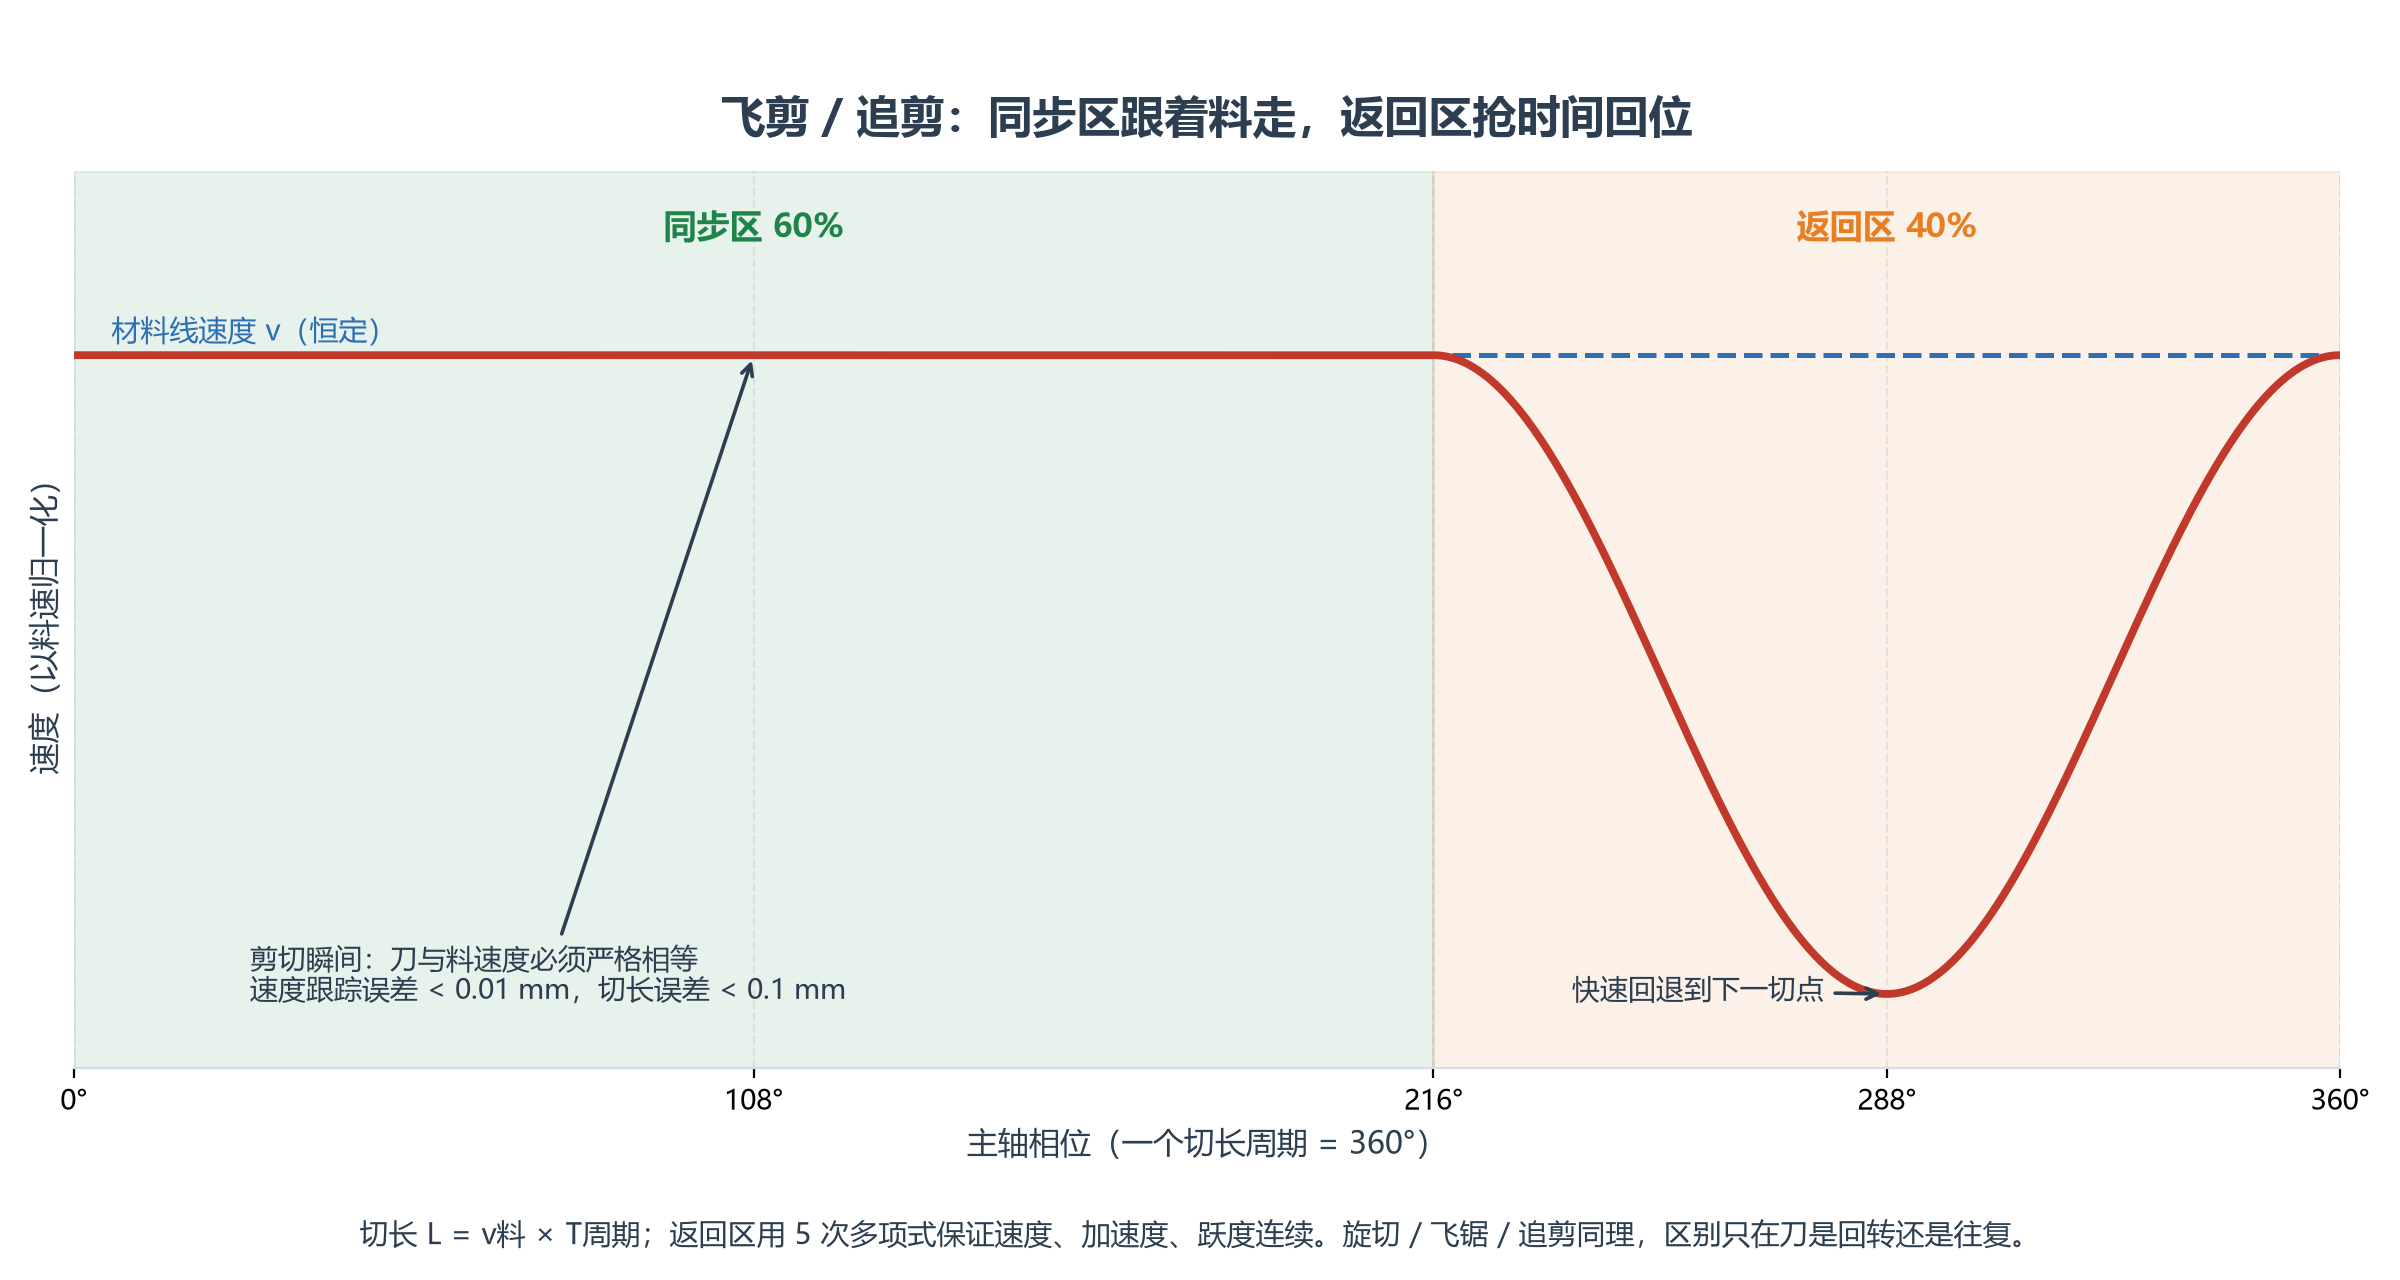
一个周期被切成两段:
- 同步区:刀的水平速度必须严格等于材料线速度,否则就是撕料、堆料或切斜。切断瞬间两者速度差越小,切口越齐。
- 返回区:刀快速减速、回退、重新加速到同步速度,赶在下一切点之前就位。这段时间越短,设备能跑的线速度越高。
基本关系很简单:切长 L = v料 × T周期。改切长不用改机械,改周期或改凸轮表即可。
一组公开工程数据(包装机飞剪案例):凸轮曲线采用五次多项式插值,同步区占凸轮周期 60%、返回区 40%;在 300 m/min 线速度下,同步区速度跟踪误差 < 0.01 mm,切长误差 < 0.1 mm。为什么用五次多项式?因为它能同时约束起止点的位置、速度、加速度(6 个边界条件),保证 C² 连续,正好把”加速度和跃度必须连续”这条写进数学里。
同一族的工艺还有旋切(回转刀辊)、飞锯(追上管材再锯断)、追剪(刀架追上材料再剪),差别主要在刀是回转还是往复、同步区占比多少,底层都是电子凸轮 + 相位同步。实机上通常还要配一个外部编码器做全闭环:用测速轮直接测材料实际位置当主轴,才能吃掉打滑和传动间隙带来的误差。
六、龙门双驱与多轴同步:两个轴各控各的,为什么还不够
大型龙门机床、激光切割、玻璃加工常用双驱:横梁左右两端各一套丝杠/直线电机,中间没有机械传动轴硬连。好处是行程可以做得很大,坏处是两端一旦不同步,横梁就会扭摆、憋劲、偏磨导轨,严重时直接别坏。
直觉方案是”两个轴各自把位置环调好”,但这不够。原因是两轴的动态特性天然不同:某双轴龙门案例中左轴惯量 120 kg·m²、右轴 95 kg·m²,差约 26%。即使各自跟踪误差都很小,两端同步误差仍可能很大——因为每个控制器只盯自己的误差,压根不知道对方在干什么。
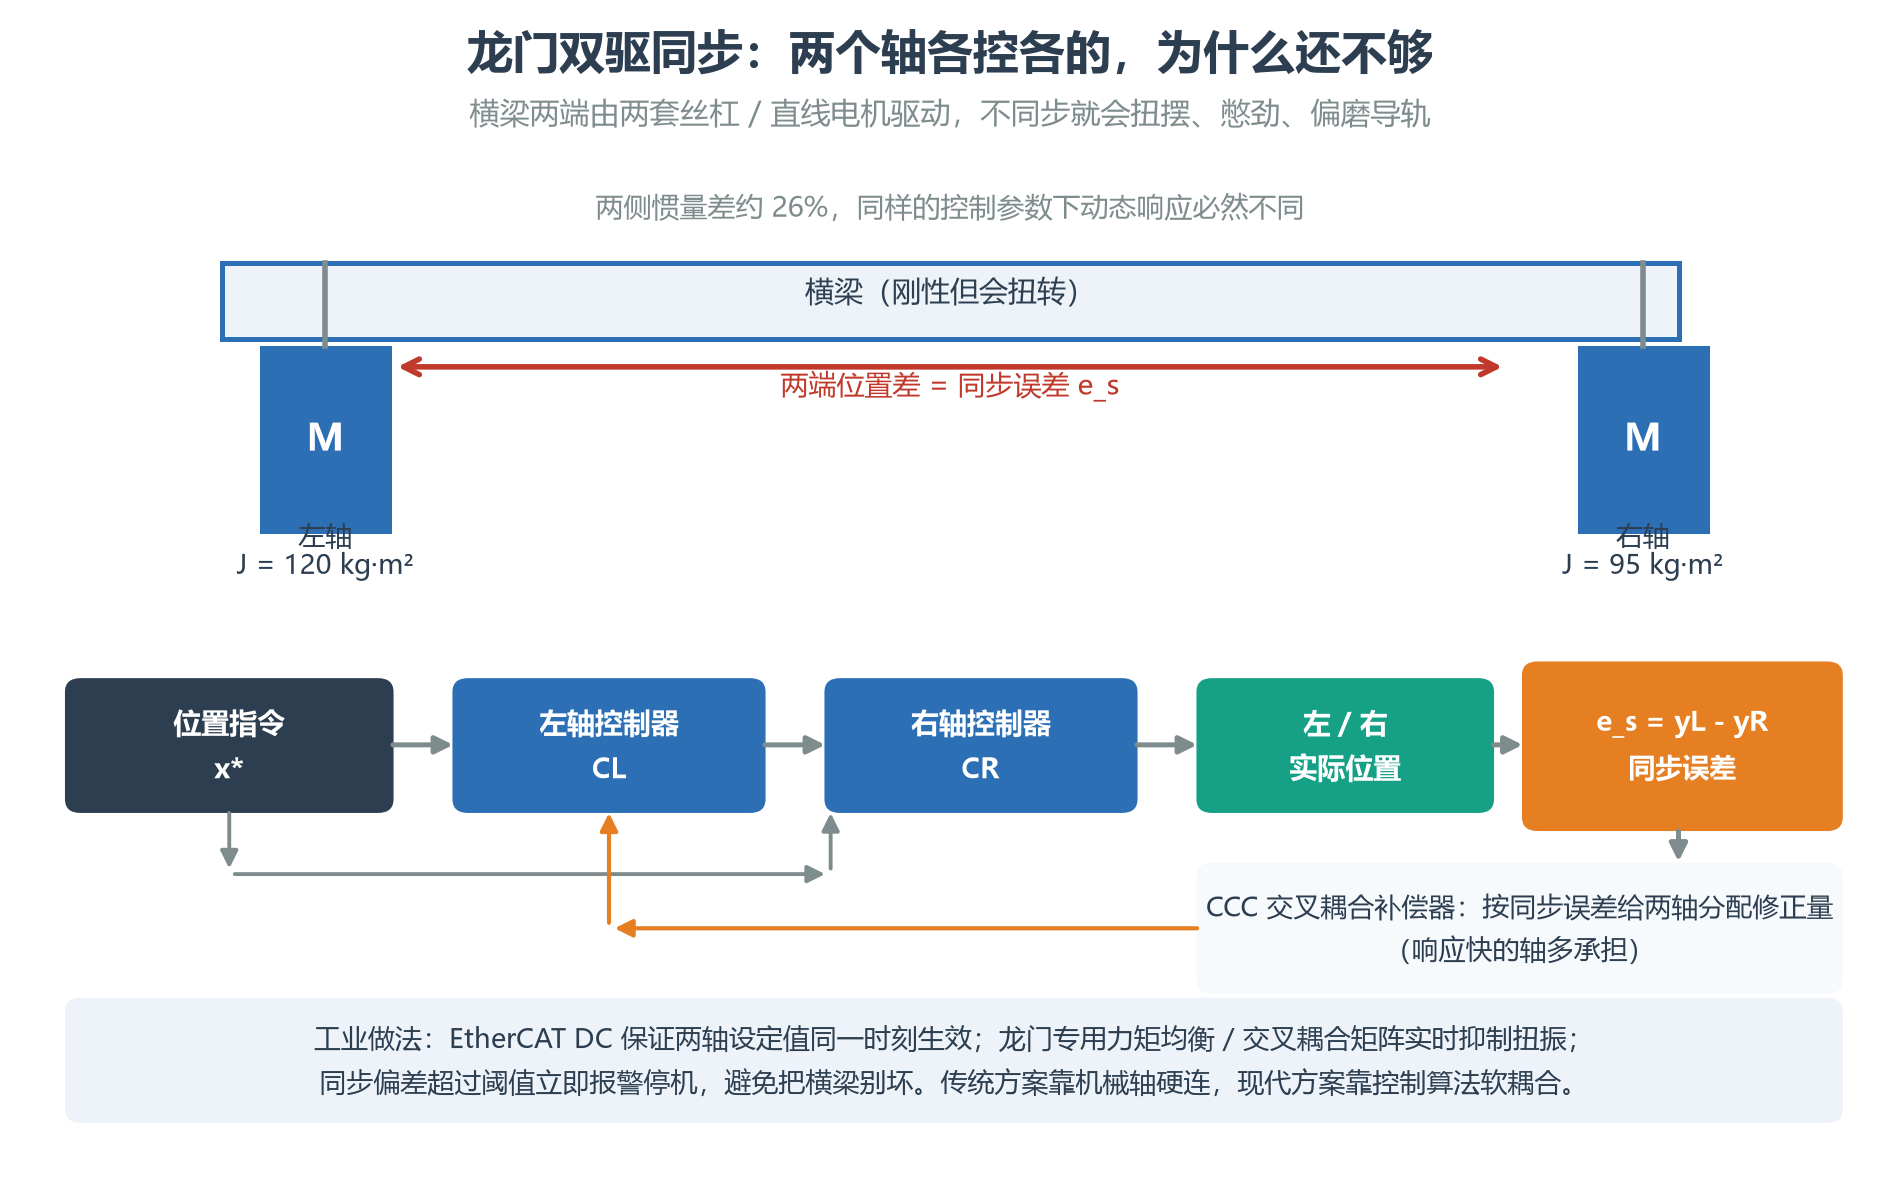
交叉耦合控制(Cross-Coupled Control, CCC)的做法是:
- 定义同步误差 es = yL – yR(减去期望的同步关系);
- 由 es 算出一个补偿量;
- 按两轴动态特性把补偿量分配回各自的控制输出——响应快的轴多承担,响应慢的少承担。
好处是不必推翻原来调好的各轴独立控制器,只在上面加一层耦合,就能显著压小同步误差。工业实现里还会叠加:EtherCAT DC 保证两轴设定值同一时刻生效、龙门专用力矩均衡算法抑制扭振、以及同步偏差超阈值立即报警停机这条保命逻辑。
和前面几篇的接点:CCC 之所以能成立,前提是”设定值能同时到达、反馈能同一时刻采样”。这正是 CSP + 分布式时钟(DC)双主站验证 要解决的问题;也是 五种连 PC 方式里,实时工业以太网最终胜出 的根本原因——低抖动比低平均延迟更重要。再往上,TSN 想做的是把这种确定性搬回标准以太网。
七、前沿之一:强化学习能进控制环吗
这几年论文里 RL 很热闹,但工程上必须先问一句:它到底该站在哪一层?
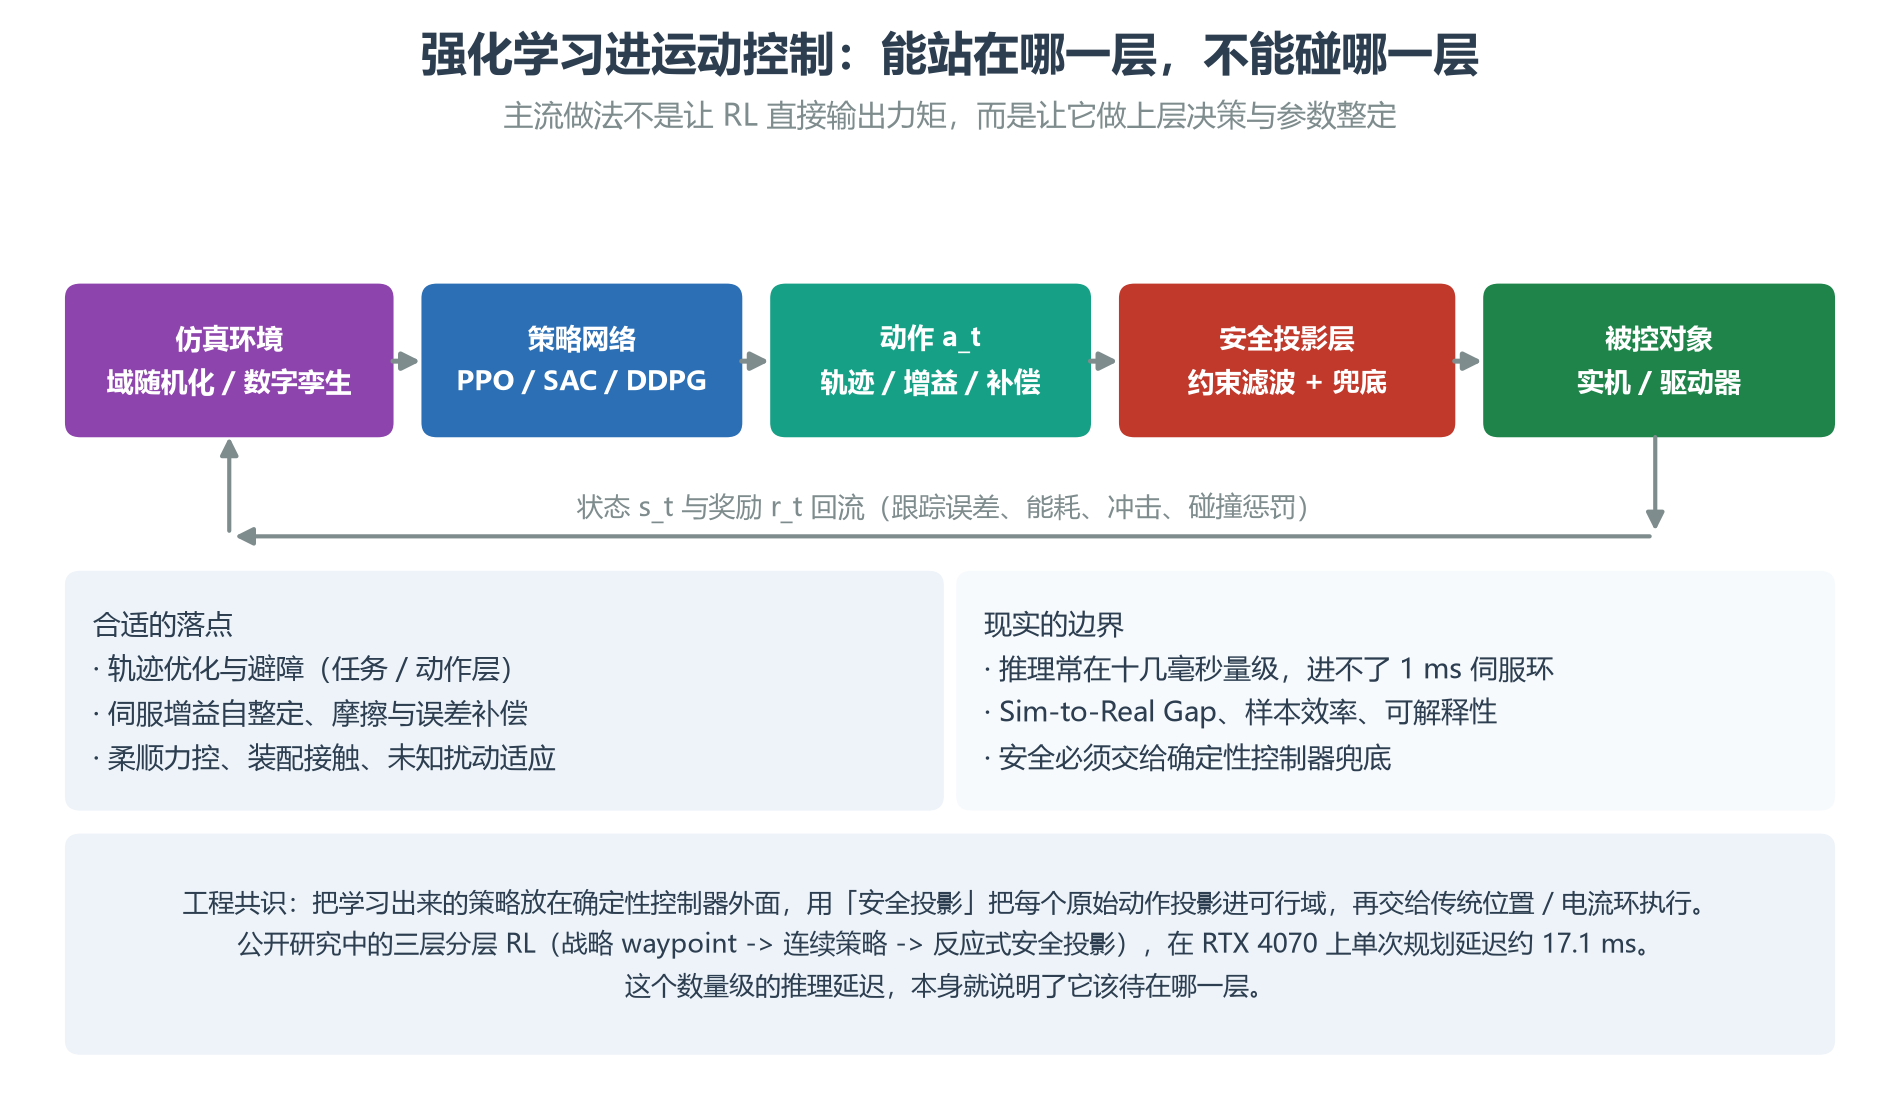
合适的落点
- 轨迹优化与避障:在任务/动作层处理非结构化环境、动态障碍,PPO、SAC、DDPG 都有大量工作;
- 伺服增益自整定:让策略根据响应自动调 PID / 前馈参数,替代人工整定;
- 摩擦、间隙、热漂移的误差补偿:这些恰恰是解析模型最难写准的部分;
- 柔顺力控与装配接触:接触动力学难建模,学习相对有优势。
已有公开结果可参考:SA-PPO(模拟退火 + PPO)在抓取轨迹规划上把成功率从 92% 提到 98%,并在 AUBO-i5 实机完成迁移;也有研究用 VLM + 边缘 AI 做焊接/涂胶的实时轨迹修正,效果优于传统自适应 PID。
但边界非常清楚
RL 不该、也目前不能进 1 ms 的伺服环。公开的三层分层 RL(战略层给 waypoint → 战术层连续策略 → 反应层安全投影)在 RTX 4070 上单次规划延迟约 17.1 ms;这个数字比插补周期大了一个数量级。再叠加 Sim-to-Real Gap、样本效率、训练稳定性、可解释性与功能安全认证,端到端”神经网络直接出力矩”在产线上仍不现实。
所以业界的共识架构是:把学出来的策略放在确定性控制器的外面,中间加一层安全投影(safety projection)——把策略输出的每个原始动作投影进满足约束的可行域,再交给传统位置环/电流环执行;急停、限位、超差这些硬安全完全不经过模型,由独立的安全控制器兜底。
一句话判断:RL 不是来取代 PID 的,它是来替上面几层做”人调不出来的参数与策略”的。这跟前面讲的”分层”完全是同一个逻辑。
八、前沿之二:”大脑-小脑-脊髓”分层,其实是老架构的新名字
具身智能这两年最常被提到的一句话是”大脑 + 小脑”。听起来很新,但把它翻译成控制工程师的语言,立刻就熟了:
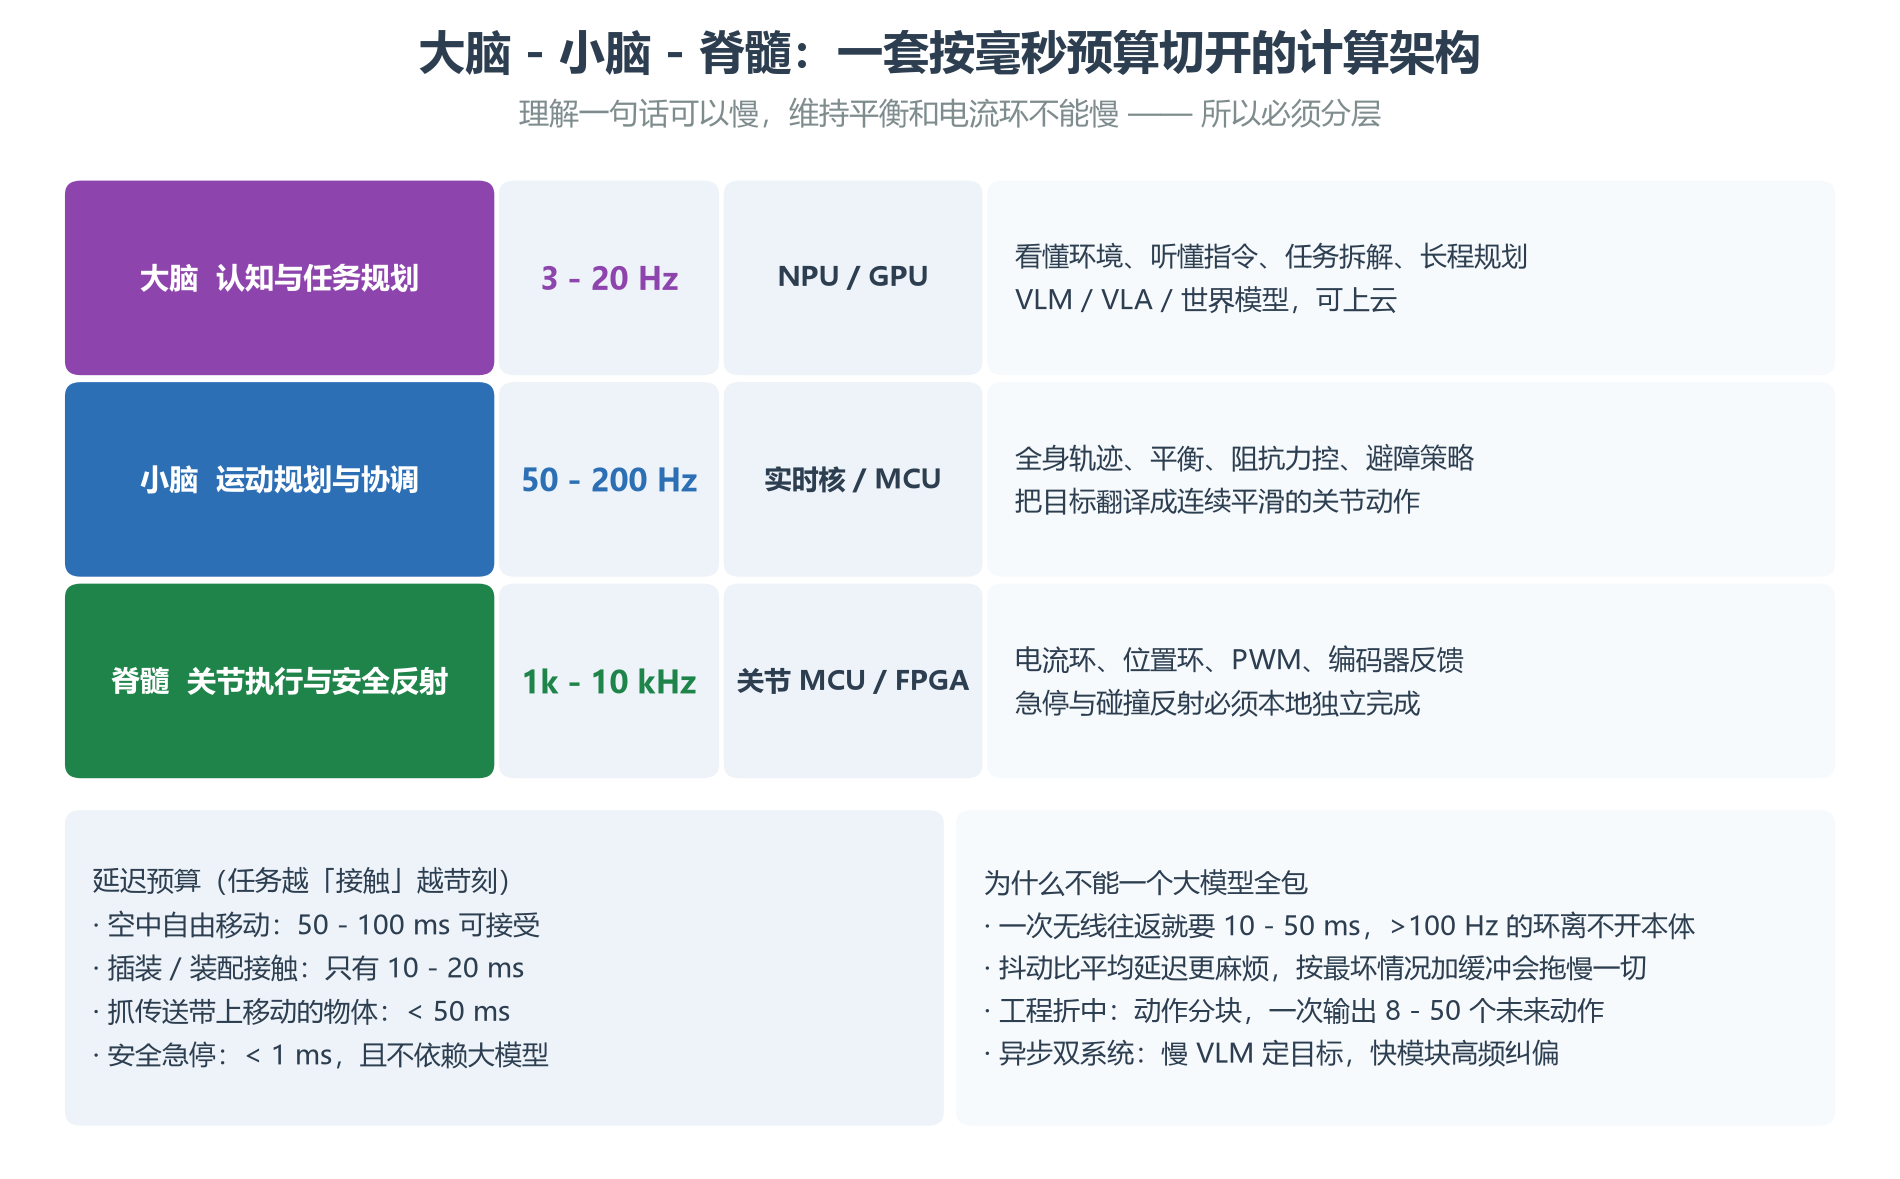
| 层 | 频率 | 算力 | 职责 |
|---|---|---|---|
| 大脑(认知规划) | 3 – 20 Hz | NPU / GPU | 看懂环境、听懂指令、任务拆解、长程规划;VLM / VLA / 世界模型,可上云 |
| 小脑(运动协调) | 50 – 200 Hz | 实时核 / MCU | 全身轨迹、平衡、阻抗力控、避障策略;把目标翻译成连续平滑的关节动作 |
| 脊髓(关节执行) | 1k – 10 kHz | 关节 MCU / FPGA | 电流环、位置环、PWM、编码器反馈;急停与碰撞反射本地独立完成 |
两个代表性架构很能说明问题:
- NVIDIA GR00T N1:慢系统是视觉语言模型,约 1 – 5 Hz 做规划;快系统用扩散 Transformer 把计划转成连续动作。
- Figure Helix:慢系统 70 亿参数 VLM,7 – 9 Hz;快系统仅 8000 万参数,却以 200 Hz 输出上半身 35 个自由度的控制指令;两者通过共享表征空间通信,端到端延迟压在 50 ms 内。2026 年 1 月 Figure 又加了 System 0,用神经网络控制器替换掉十万行以上手写运动控制代码。
为什么不能一个大模型全包
因为延迟预算是按任务类型分档的,而且越”接触”越苛刻:
| 任务 | 可接受推理延迟 |
|---|---|
| 机械臂空中自由移动 | 50 – 100 ms |
| 插装、装配等持续接触任务 | 10 – 20 ms |
| 抓取传送带上移动的物体 | < 50 ms |
| 安全急停 | < 1 ms,且必须由独立安全控制器完成,不能依赖大模型 |
一次普通无线往返就要 10 – 50 ms,所以100 Hz 以上的控制环基本不可能离开本体,能上云的只有 20 Hz 以下的规划。比平均延迟更麻烦的是抖动:指令忽早忽晚,控制器不知道下一次更新何时到,只能按最坏情况加缓冲,代价是每次动作都为最坏情况买单。工程上的折中是动作分块(一次输出 8 – 50 个未来动作,边执行边算下一块)和异步双系统(慢 VLM 定目标,快模块高频纠偏)。
这一节最想说的一句:把”大脑-小脑-脊髓”和本文第一张图并排放,你会发现它们几乎是同一张图。传统运动控制器早就分成「任务/工艺 → 轨迹规划 → 精插补 → 伺服环」,AI 时代只是把最上层从 G 代码 / 示教器换成了 VLM,中间层和底层一点没变,频率约束更是一点没变。
所以别被”端到端大模型”这个词吓住。真正落地的系统,依然是上层慢而聪明、下层快而确定;而把下层做扎实——加减速、插补、同步、DC、安全兜底——恰恰是长期做运动控制的人最擅长、也最难被替代的部分。具身智能不缺”大脑”,缺的是能把 200 Hz 和 10 kHz 这两层写稳的”小脑和脊髓”。
九、给工程师的落地清单
| 现象 | 优先排查 | 涉及本文 |
|---|---|---|
| 启停”哐”一声、停稳慢、表面有振纹 | 是不是还在用梯形?a 阶跃导致 jerk 无穷。先加 jerk 限制 / 降 jmax,而不是一味降 amax | 二 |
| 长行程正常、短行程发软或过冲 | 7 段 S 因达不到 vmax/amax 退化成 4/6 段,需按行程重解各段时长 | 二 |
| 小线段加工节拍上不去、机床”点头” | 前瞻段数不足、拐角未按 v ≤ √(a·R) 限速、段间没做 Blend | 三 |
| 高速电子齿轮有固定微米级偏差 | 先算指令延迟(周期 × 线速度),再查编码器分辨率;确认 DC 已启用 | 四 |
| 飞剪切长忽长忽短、切口发斜 | 同步区速度是否真等于料速;主轴是否用了外部测速轮做全闭环;凸轮表 a/j 是否连续 | 五 |
| 龙门横梁扭振、导轨偏磨 | 两轴惯量/摩擦是否差异大;加 CCC 与力矩均衡;设定值是否同拍生效 | 六 |
| 想把 RL / 大模型接进控制器 | 先问推理延迟属于哪一档;安全投影层与独立急停做了没有;别让学习策略进硬实时环 | 七、八 |
调试顺序建议:机械与惯量匹配 → 电流环 / 速度环 → 位置环与增益 → 加减速曲线与 jerk → 前瞻与插补 → 多轴同步与总线抖动 → 最后才轮到上层智能。这个顺序反过来做,几乎一定会在现场反复返工。
写在最后
把这篇和前几篇连起来看,一条线就清楚了:
- 运动控制器是什么、怎么连 PC —— 解决”算力的位置“;
- EtherCAT 标准全景、CiA 402 入门 —— 解决”大家说同一种语言“;
- CSP 双主站验证、从站研发路线 —— 解决”别人家的主站也认“;
- 本篇 —— 解决”设定值到底怎么算出来、多轴怎么对时“。
算法会换、模型会换、总线也会换(TSN 还在往前走),但那个最朴素的约束一直没变:在正确的时间,把正确的位置,送到正确的轴上。理解了这句,梯形曲线、凸轮表、交叉耦合、乃至”大脑-小脑”分层,都只是它的不同写法而已。
运动控制轨迹规划S 形加减速插补电子凸轮飞剪龙门同步PLCopen MC强化学习具身智能
本文为海川嵌入式电子网原创技术文章。文中工程数据来自公开的工业案例与学术文献,用于说明量级关系,实际参数请以设备手册与现场调试为准。